En esta entrada se proporcionará alguna información básica sobre el Sequence Retrieval System (SRS), en primer lugar, y nos centraremos en su manejo después. SRS es un servicio de búsquedas en bases de datos (similar a Entrez del NCBI), que pertenece al Laboratorio Europeo de Biología Molecular (EMBL), una importante institución de investigación en Biología Molecular, financiada por 18 países europeos.
En primer lugar accederemos a la página principal del buscador, que nos muestra una clasificación de las bases de datos (SRS reúne unas 400), entre las que podemos distinguir unas más generales (Taxonomy, OMIM, EDAM, etc.) de otras más específicas (como por ejemplo, específicas para secuencias: Patent DNA, EMBL MGA, Uniprot, etc).
Para conocer cuántas y cuáles son las bases de datos que nos proporciona el servicio, seleccionamos la pestaña databanks, donde obtendremos un listado de las mismas clasificadas en distintos grupos (según el tipo de información que albergan) y con algunos datos interesantes, como el número de entradas que contienen o su posible disponibilidad.
A simple vista, en la columna Nº of entries observamos que la base de datos que más datos contiene es Livelists.
La columna Indexing date, nos proporciona la fecha de las últimas actualizaciones que se han llevado a cabo. Por ejemplo, observamos que la más reciente (con fecha de este mismo día, 3 de abril de 2013) se corresponde con Taxonomy (base de datos que recoge el nombre de todos los organismos que están representados en las bases de datos de secuencias con, al menos, una secuencia nucleotídica o proteica). Accediendo a su correspondiente enlace, obtenemos la última actualización realizada y el número total de entradas hasta la fecha.
Ahora veremos qué tipo de información podemos extraer de una de las herramientas de SRS. Como ejemplo hemos elegido el IPD-MHC.
IPD-MHC es un subgrupo dentro de la base de datos de inmuno polimorfismos (IPD), un conjunto de bases de datos especializadas en el estudio de genes polimórficos en el sistema inmune. El resto de bases de datos que la componen son : IPD-KIR, IPD-HPA, IPD-ESTAB. En particular, IPD-MHC es una base de datos que contiene secuencias pertenecientes al complejo mayor de histocompatibilidad de diferentes especies.
En la misma página, nos indica que la versión actual (1.8.0) cuenta con 3.884 entradas en su última actualización (20 de noviembre de 2012).
Si tenéis alguna duda sobre el funcionamiento de SRS o simplemente queréis profundizar en el resto de servicios que proporciona, entrando en el menú Help de la página principal (o haciendo click aquí) accederéis a un tutorial que detalla los distintos aspectos que recoge esta Base de Datos.
Como podemos comprobar, este modo de búsqueda ofrece muchos campos, entre otros: topología, tipo de molécula, división, longitud de la secuencia, número de accesión, fecha de entrada, de publicación y de actualización, palabras clave, proyecto genómico, taxón, etc.
Una prueba de la alta especificidad que permite este servicio, se encuentra en la variedad de divisiones que presenta. Éstas se muestran a continuación, con sus respectivos códigos: env (muestras ambientales) , fun (hongos), hum (humanos), inv (invertebrados), mam (otros mamíferos), mus (Mus musculus), phg (bacteriófago), pln (plantas), pro (procariotas), rod (roedores), syn (sintéticos), tgn (transgénicos), unc (sin clasificar), vrl (virus), vrt (otros vertebrados).
Como muchas otras bases de datos, podemos enlazar términos en nuestra búsqueda, sin más que utilizar los comandos: & (AND), | (OR); ! (BUTNOT).
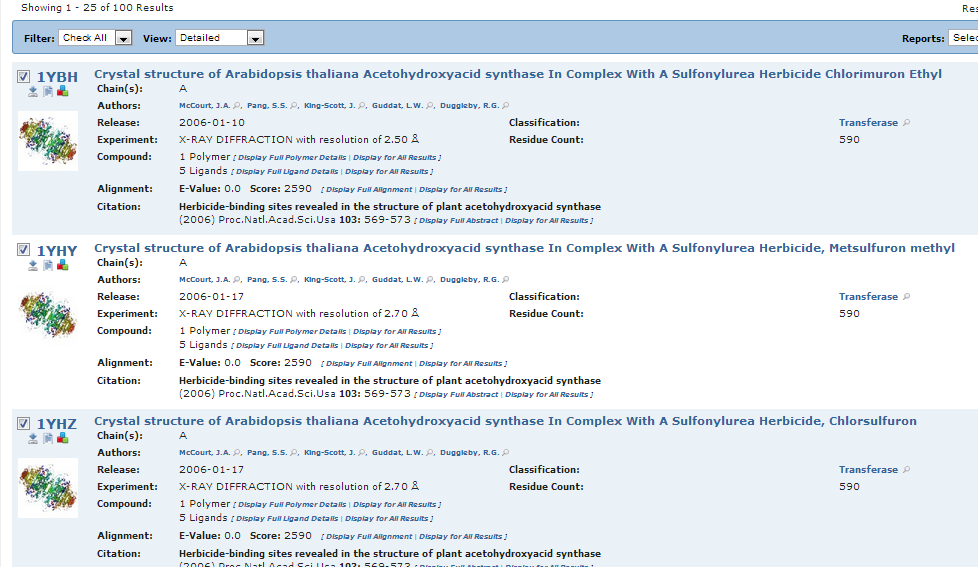
Como ejemplo de esta última explicación, vamos a buscar bibliografía científica referida a la enzima acetolactato sintasa en procariotas. Una vez realizada la búsqueda, hemos obtenido 67 resultados. Haciendo click, por ejemplo, sobre el primero de ellos aparecerá una nueva página, desde la que podremos acceder a las referencias bibliográficas y a partir de ahí todo tipo de información al respecto.